技术解读
为什么我们是真·5mm精度:灵光 L3 精度验证报告速读
拒绝虚标!灵光L3手持扫描仪通过1524条靶标距实测,P68分位达标真5mm精度。
而基于真实世界采集构建的 3D 高斯泼溅(3DGS),正在成为当前最具实用性的空间数据表示方式之一
大语言模型之所以能够以如此快的速度发展,一个重要原因在于:数字世界中早已积累了海量的文本和上下文信息。多年来的网页内容、电子书、代码仓库以及结构化数据库,为像 ChatGPT 这样的大语言模型提供了足够丰富的训练材料,使其能够大规模学习人类语言与推理中的模式。
但当 AI 系统需要真正进入物理世界——当机器人要在仓库中导航、车辆要理解复杂路口、无人机要执行基础设施巡检——它们所需要的,就不再只是文本,而是另一类完全不同的数据:空间理解能力。也就是说,它们需要准确的三维几何、真实世界的外观、可反映物理结构的信息,以及空间中物体之间的关系。这正是业界日益重视的"具身智能仿真世界模型"。
问题在于,与文本相比,三维和物理空间数据的获取难度高得多。空间信息并不存在一个类似“爬取互联网”那样的获取方式。每一个场景,都必须被单独采集、重建并结构化处理,AI 系统才能真正从中学习。
而基于真实世界采集构建的 3D 高斯泼溅(3DGS),正在成为当前最具实用性的空间数据表示方式之一:它渲染速度快、视觉效果逼真,并且能够适配具身智能所依赖的仿真流程。
但 3DGS 本身主要捕捉的是外观,而不是物理精度。若要生成真正可供机器人训练使用的空间数据,3DGS 还必须建立在准确几何结构之上——而这类几何基础通常来自激光雷达与多模态感知,而不仅仅是相机。也正是视觉保真度与几何真实性的结合,才让一个三维场景从“可看”变成“可用”的基础设施,这也是 XGRIDS 持续在构建的核心能力。
具身智能是指能够在物理环境中感知、推理和行动的自主系统,涵盖机器人、自动驾驶车辆和智能空间等形态。在定义和推广这一概念上投入最多的 NVIDIA,披露其 2026 财年具身智能相关营收已超过 60 亿美元,并预测该市场在未来十年内有望达到数千亿美元规模。
在 2026 年 NVIDIA GTC 大会(3 月 16 日至 19 日)上,黄仁勋进一步表态。他宣称"具身智能时代已经到来——每一家工业企业都将成为机器人公司",并发布了具身 AI 数据工厂蓝图——一套用于大规模生成、扩充和评估机器人及自主系统训练数据的开放参考架构。其核心目标是:用仿真与合成数据取代昂贵的真实世界数据采集,将机器人领域的数据瓶颈转化为算力问题——前提是仿真环境必须足够真实。而这个前提,正是后续一切讨论的关键所在。
要训练一个机器人从货架上抓取物品、在建筑工地中穿行,或对地下基础设施进行巡检,就需要一个能准确还原特定货架、特定工地或特定隧道的仿真环境。通用三维场景无法捕捉那些真正重要的细节:不平整的地面、特定的光照条件、表面的磨损痕迹,以及只存在于某个具体场所的空间关系。具身智能系统需要的,是针对其实际作业场景、在空间上精确、物理上可靠、视觉上逼真的数字孪生体。
过去,人们通常会将仿真与现实之间的差距归结为某一个单一问题:要么是物理问题(例如仿真中的摩擦与真实情况不一致),要么是视觉问题(例如机器人在现实中看到的纹理和光照,在仿真中并不存在)。但真实情况是,结构、物理和视觉三者缺一不可,任何一个环节出问题,都会影响从仿真到现实的迁移效果。照片级真实的渲染,如果几何误差达到 10 厘米,依然没有意义;几何结构再准确,如果纹理表现不真实,依赖视觉的策略同样难以生效;即便结构和外观都足够接近真实,如果仿真无法准确反映物体在推动、抓取或碰撞过程中的交互行为,最终效果仍会打折扣。
有三项研究清楚表明,缩小视觉与结构层面的差距,能够带来可量化的仿真到现实的提升:
SplatSim(卡内基梅隆大学,2024) 基于 3D 高斯泼溅渲染生成的照片级真实数据训练出的策略,在无需任何真实世界微调的零样本条件下部署到真实机器人时,平均成功率达到 86.25%(采用噪声注入、颜色扰动等标准数据增强),而直接使用真实数据训练的策略成功率为 97.5%。
RL-GSBridge(2024) 则更直接地验证了结构层面的影响。该研究比较了基于传统网格渲染仿真训练的策略与基于 3DGS 渲染仿真训练的策略。无论是结构规则的对象(如简单立方体),还是非规则对象(如复杂纹理物体),前者在迁移到真实环境时成功率都明显下降,而后者则保持了显著更高的性能。
Discoverse(清华大学 AIR DISCOVER 实验室,2025) 则进一步将视觉与物理两个维度结合起来,构建了一个完整的 3DGS 仿真平台,并与 MuJoCo 物理引擎集成。在使用模型微调(Action Chunking with Transformers)进行模仿学习的基准测试中,在采用相同数据增强方式的前提下,Discoverse 在仿真到现实迁移上的表现比 SplatSim 提升了 18.5%;在扩散策略 (Diffusion Policy)任务中,提升幅度为 11.4%。这些提升同时来自更高的视觉保真度和更紧密的物理集成,也进一步说明,这几个维度之间并不是相互替代的关系,而是相互叠加、共同发挥作用。
声明:其域创新为清华 Discoverse 项目提供了软硬件支持。本文引用的数据均来自已发表并经过同行评审的研究成果。
用于仿真创建三维环境的方法有很多。传统的网格建模、摄影测量、神经辐射场(NeRF),以及 3D 高斯泼溅都可以生成三维内容。但它们并不都同样适合具身智能训练的需求。
| 属性 | 为什么对物理 AI 很重要 | 3DGS 的优势 |
| 来自真实采集的视觉保真度 | 当训练画面与实际部署环境存在偏差时,基于视觉的 AI 策略就容易失效。 | 3DGS 可直接基于相机/激光雷达数据重建场景,保留真实世界的纹理、光照和空间细节,这是人工建模难以还原的。 |
| 实时渲染 | 强化学习往往需要数百万帧的渲染。渲染过慢会形成瓶颈,使大规模训练难以开展。 | 3DGS 可以实现实时帧率渲染,比 NeRF 快几个数量级,因此更适合交互式训练循环。 |
| 显式空间数据 | 物理引擎依赖可参与碰撞和动力学计算的几何结构,而像 NeRF 这样的隐式表示无法直接用于物理仿真。 | 每个高斯体都具有明确的位置、尺度和旋转信息,可与网格绑定用于物理仿真,这一点已在 RL-GSBridge、Discoverse 等工作中得到验证。 |
| 结构化空间输出 | 具身智能系统需要的不只是图像,还需要可导航地图、障碍物边界、表面法线和语义标签等信息,才能完成规划与决策。 | 融合激光雷达的 3DGS 能编码具备度量精度的空间结构,这些信息既可查询、标注,也可转换为仿真平台可直接使用的格式(如 OpenUSD 等) |
| 大规模场景支持 | 机器人实际运行在仓库、工地和城市中,而不仅仅是桌面级场景里工作。 | 基于激光雷达与视觉融合的 3DGS 可以重建从建筑到城市尺度的环境,精度达到厘米级,远超单房间采集能力。 |
有一点值得明确指出:
并非所有 3DGS 都同样适用于具身 AI。
AI 生成类三维工具可以从少量照片生成视觉效果惊艳的 3DGS 模型。随手拍几张厨房的照片,就能得到一个美观、可导航的三维场景。但这样的模型与空间的物理现实之间并不存在可靠的对应关系——尺寸可能只是近似值,被遮挡区域的几何结构可能是"幻觉",也不存在供物理引擎进行仿真的度量精确空间结构。它看起来是对的,但在机器人训练真正在意的层面,它并不对。
对于具身智能而言,采集来源决定了后续一切工作的质量上限。问题不在于能否生成 3DGS,而在于这个 3DGS 是否编码了仿真流程真正所需的结构化空间与物理数据。
在 NVIDIA GTC 2026 上,黄仁勋再次展示了那张他称为“最喜欢”的幻灯片:一张关于结构化数据生态的图谱,涵盖 SQL、Spark、Pandas、Snowflake、Databricks 以及各大云平台。他表示:“这是商业世界的事实基准,也是企业计算的事实基准。” 他的核心观点是:生成式 AI 要想真正做到可信、可用,离不开结构化数据的支撑,而整个企业技术栈,也需要围绕这些数据的高效处理与调用方式重新构建。
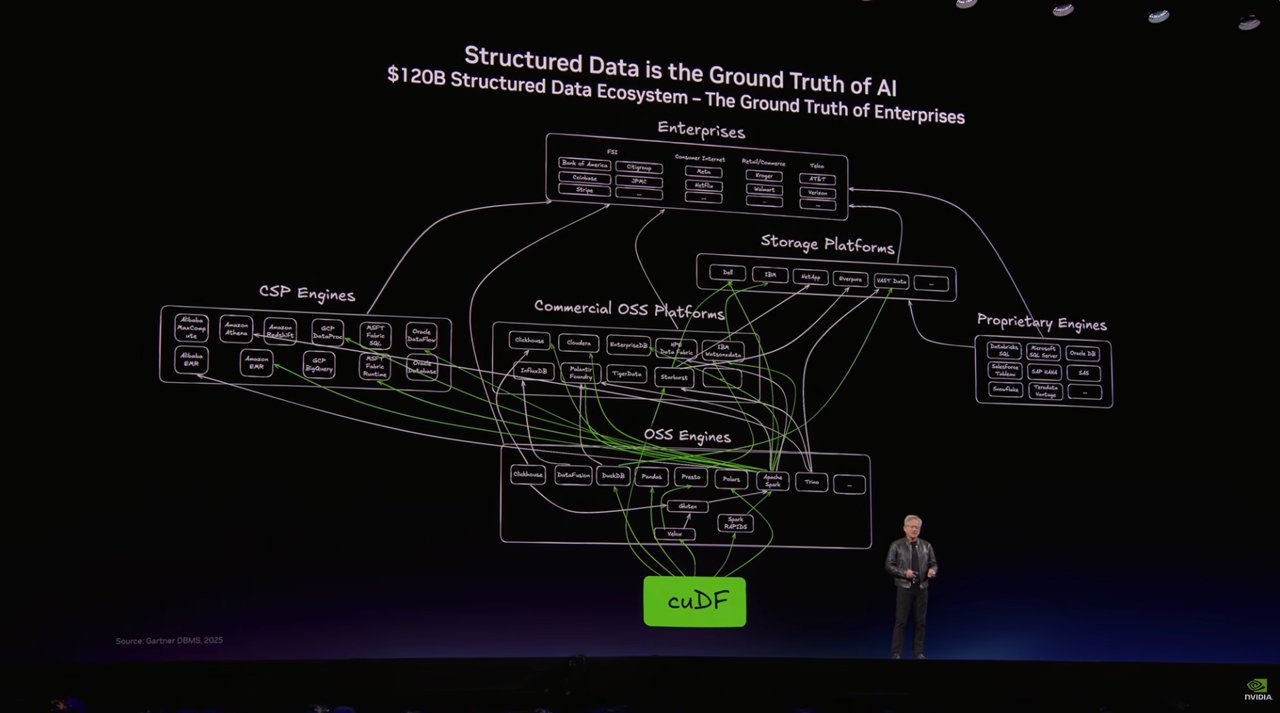
同样的逻辑也适用于具身智能,只不过对应的数据类型变成了“空间数据”。
对于运行在物理空间中的 AI 系统来说,所谓“事实基准”不再是数据库中的一行行记录,而是能够准确描述真实环境几何结构、外观特征和空间关系的结构化三维数据。如果说结构化企业数据决定了语言大模型的可靠性,那么结构化空间数据决定的,就是具身智能的可靠性。
这也是我们理解文件格式 LCC(Lixel CyberColor)的角度。LCC 的设计目标,就是承载物理 AI 流程所需要的结构化空间信息,包括几何、颜色、位置和尺度等关键数据。
当 NVIDIA 的 Omniverse NuRec 利用 3DGS 将传感器数据转换成交互式仿真环境时,输出质量完全取决于输入数据本身的质量和组织方式。而 LCC 想回答的,正是“什么样的输入,才真正适合具身智能训练与仿真”这个问题:它是一种开放格式,旨在尽可能保留后续仿真、渲染和推理所依赖的空间保真度。
如果说结构化数据是企业 AI 的“事实基准”,那么结构化空间数据就是具身智能的“事实基准”。而这条从采集到格式化的整条链路,本质上是一套完整的空间智能平台能力,而不只是某个单独功能。
3DGS 具备速度快、视觉真实感强的优势,但仅凭标准的 3DGS 重建结果,本身还不足以直接用于仿真。
从原始 3DGS 输出,到真正能够被具身智能训练流程使用,中间仍然存在一些关键缺口。而 XGRIDS 所构建的平台,正是围绕这些缺口展开的。
标准 3DGS 在受控环境下通常表现良好,例如光照充足、纹理清晰、尺度适中的场景。
但在具身智能真正部署的环境中——例如地下隧道、工业设施、多层建筑——纯视觉方式构建的 3DGS 往往会出现明显局限。
XGRIDS 的流程采用基于 SLAM 的激光雷达+视觉融合方案,在更复杂的条件下依然能够保持几何精度,包括非理想光照、精细结构、弱纹理区域,以及超出纯相机采集能力范围的大尺度空间。
3DGS 能够还原一个场景“看起来是什么样”,但如果要用于仿真,还必须进一步知道这个场景“在物理上是什么样”——例如表面在哪里、哪些区域是实体、机器人会与什么发生碰撞。
XGRIDS 的激光雷达融合方案能够提供准确的深度信息和分层空间结构,而 LCC 流程则会在生成 3DGS 视觉表达的同时,同步输出可用于物理碰撞计算的网格几何。
这种“双输出”结构——一套用于渲染的高斯斑点(splats),一套用于物理仿真的网格模型(mesh)——使得同一次采集结果,能够同时支撑仿真系统中的视觉层与物理层。
以地下矿山中自动驾驶车辆的仿真为例,这类环境通常昏暗、多尘,且几何结构复杂。纯视觉采集在这种条件下往往难以稳定工作。激光雷达提供几何骨架,视觉数据提供表面外观,两者融合后,才能生成一个既具备可测量精度、又在视觉上高度真实的 3DGS 环境——而这正是最能体现采集方式与 AI 训练效果之间关系的场景。
真实世界的采集结果中,往往包含大量仿真环境并不需要的噪声信息,例如移动中的行人、停放的车辆,或临时出现的物体。
XGRIDS 的流程包含动态对象移除与语义空间识别能力,能够输出更加干净、可用的场景结果,使环境中的各类元素都能够被识别、分类与调用。而这种结构化输出,正是下游系统真正“理解空间”的基础——它们不只是能够把空间渲染出来,更能够围绕空间进行推理。
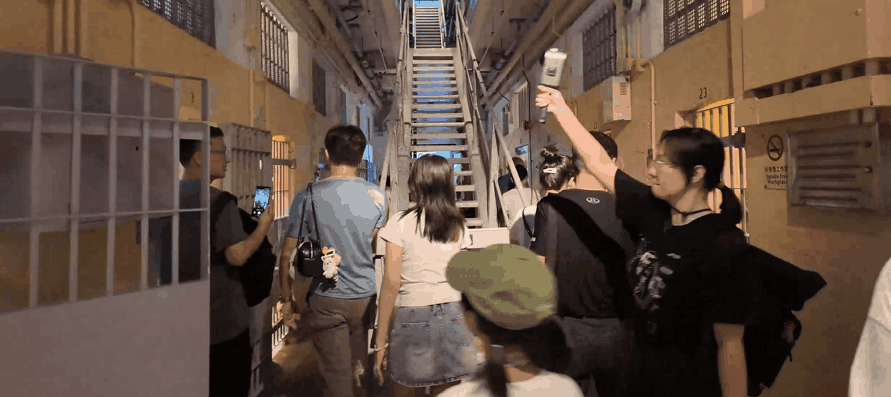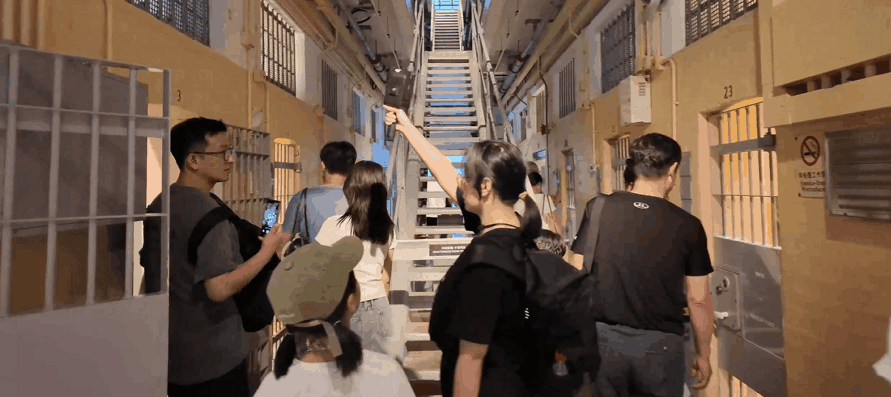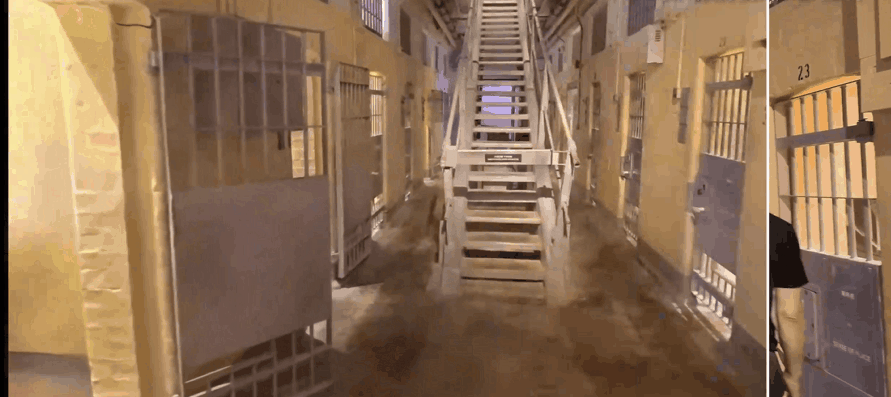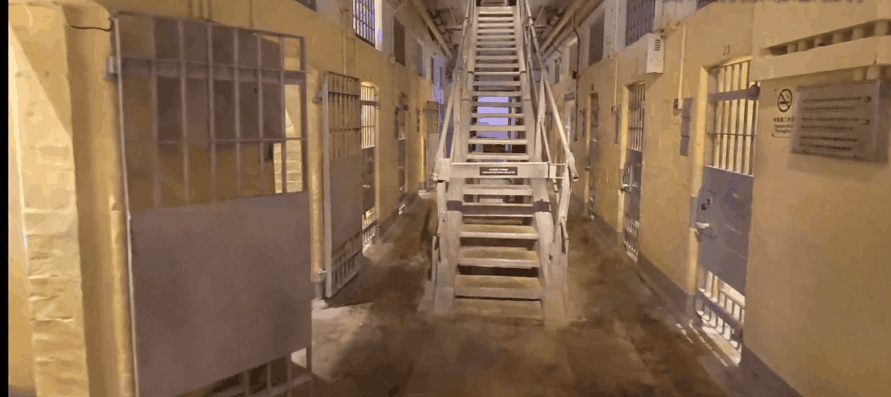
动态物体去除(Dynamic Object Removal)
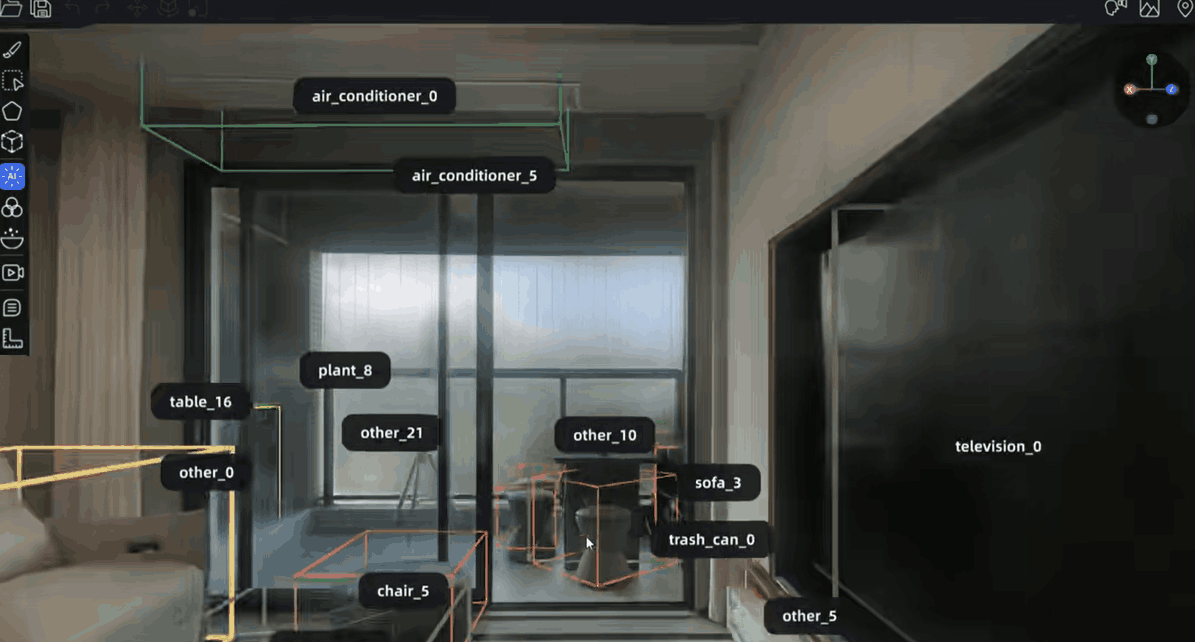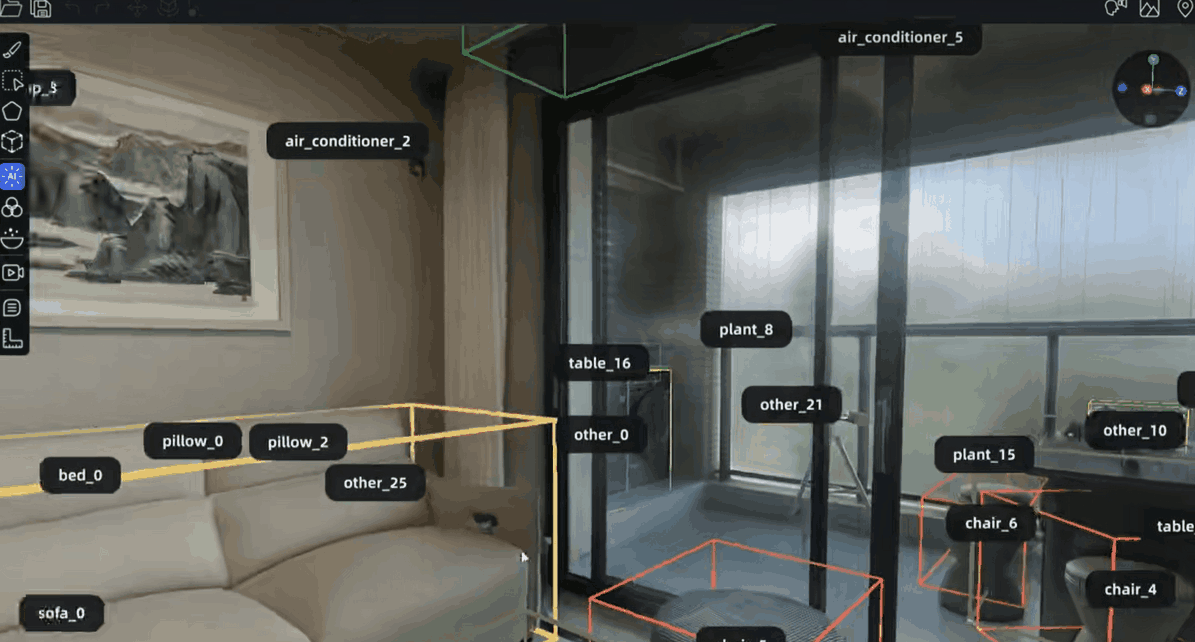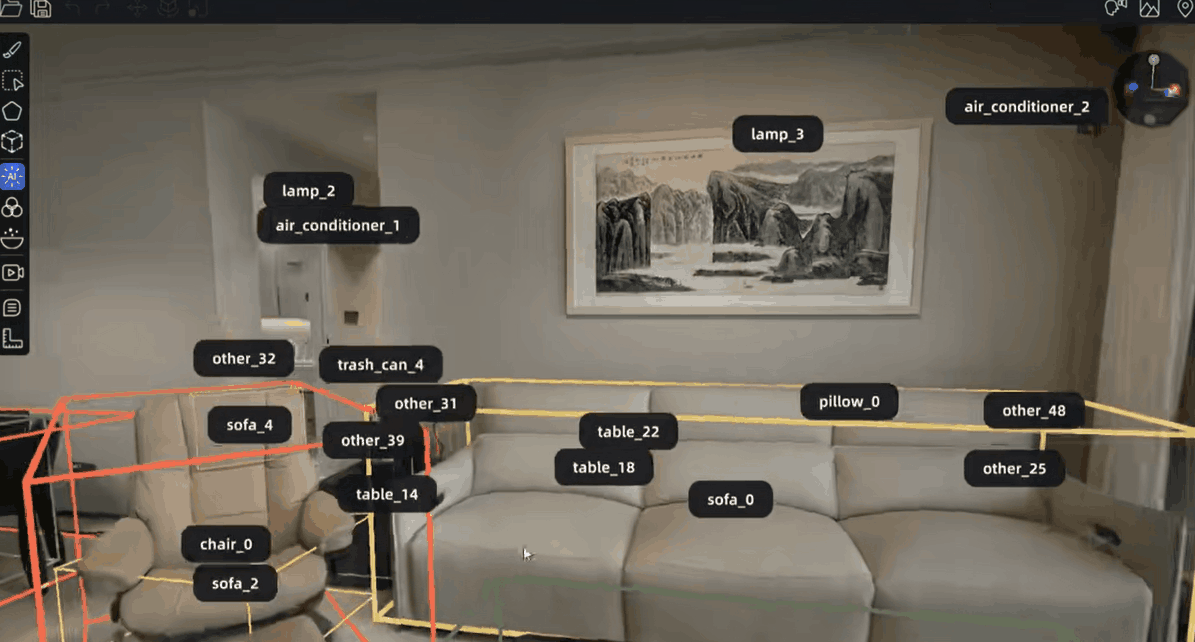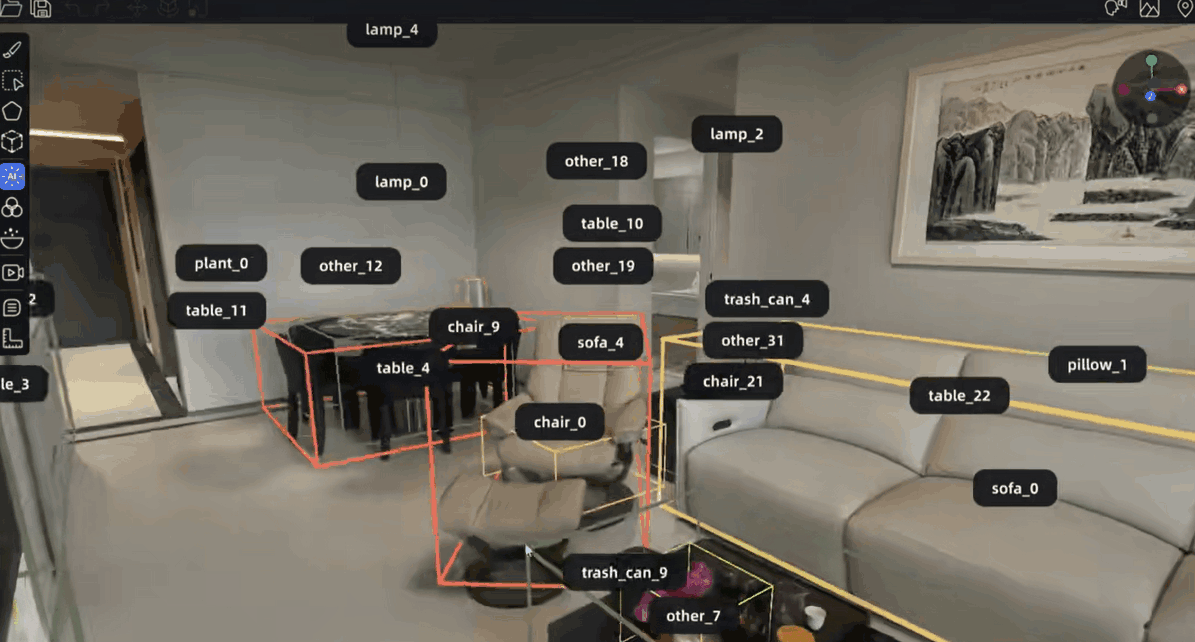
语义空间识别(Semantic Spatial Recognition)
LCC 格式进一步将 3DGS 数据组织为不同的空间层级,不同层分别承载不同类型的空间信息。
对于大尺度环境,系统还可通过 Level of Detail(LoD) 策略按需加载不同分辨率的数据,使下游系统只访问当前任务真正需要的细节层级。也正是这种分层组织方式,使这些数据不仅“看起来真实”,更真正具备机器可读性与可计算性。
这条流程并不止步于生成一个三维模型。
XGRIDS 的真实到仿真(Real2Sim)工作流可以直接导入 NVIDIA Isaac Sim,用于机器人策略的训练与验证。
这一流程已被收录进 NVIDIA 官方 Isaac Sim 文档,并以 “从 LCC-3DGS 扫描到仿真,加速 Isaac Sim 中的场景生成”(From LCC-3DGS Scan to Simulation: Accelerating Scene Generation in Isaac Sim) 的形式出现在社区亮点项目中。这意味着,XGRIDS 所生成的空间数据,在结构一致性、物理合理性和工程稳定性方面,已经满足 NVIDIA 具身智能训练基础设施的要求。
在 GTC 2026 上,这条流程曾在三个不同场合进行展示。其中有一个演示尤其直观地展示了这条链路的意义。
在 NVIDIA GTC 2026 主舞台上,
Blue——由 NVIDIA、Google DeepMind 和 Disney Research 共同开发的人形机器人——展示了如何在 NVIDIA 总部办公空间的数字孪生环境中进行训练:理解环境、规划路径并执行动作。
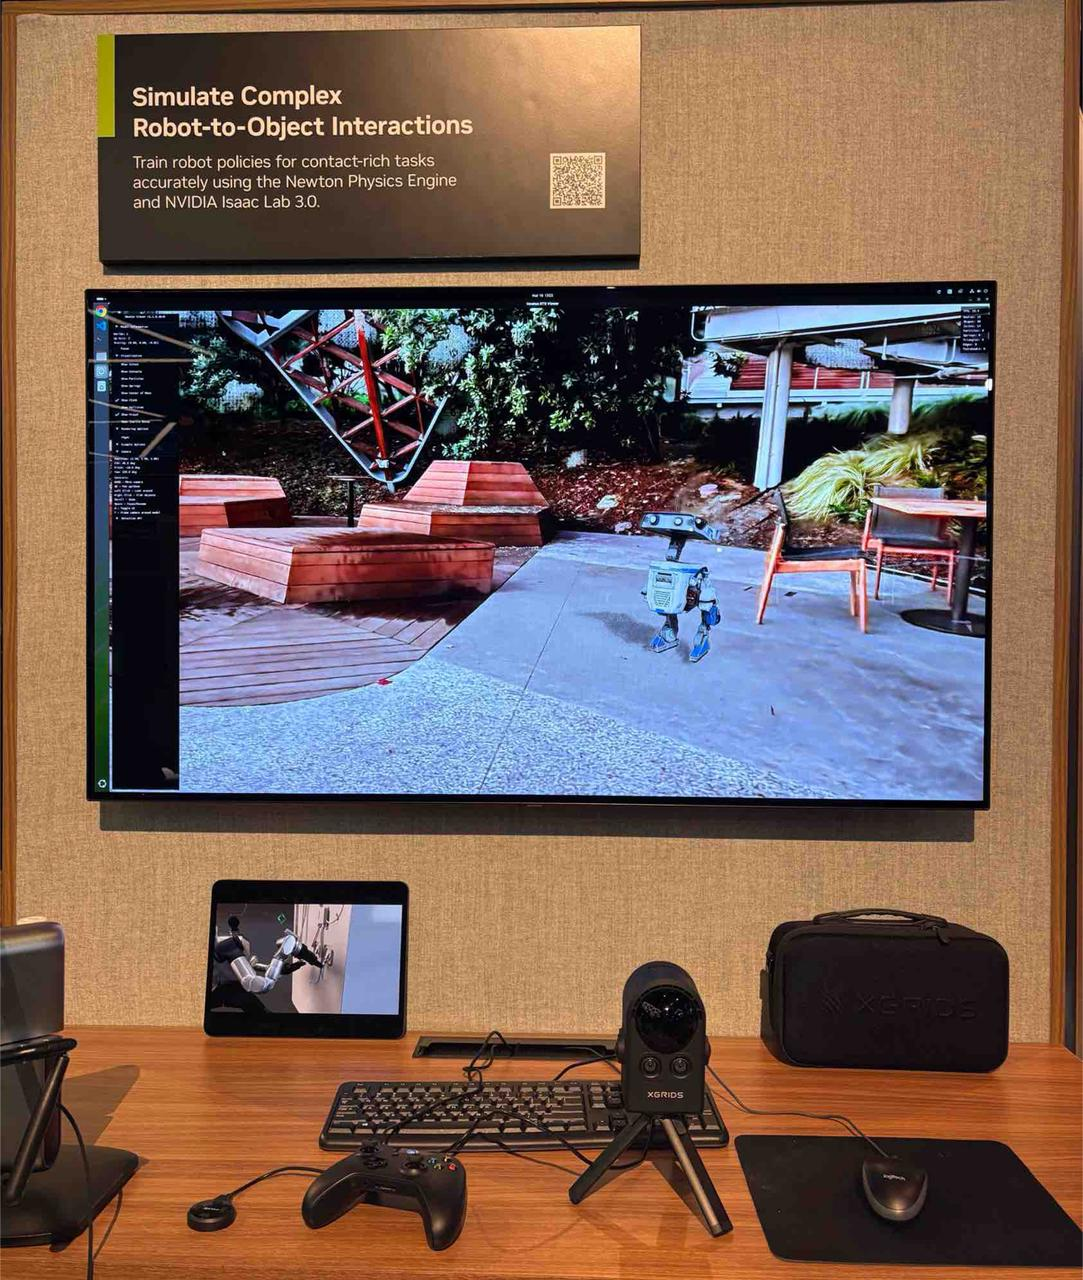
这个训练环境并不是人工搭建的虚拟场景,而是对真实 NVIDIA 办公空间进行完整数字化重建后,通过 XGRIDS 的真实到仿真(Real2Sim)流程转换得到的可仿真世界模型。
也就是说,机器人能够在与未来实际运行空间高度一致的环境中进行大规模训练,而在学习过程中甚至无需进入真实建筑。
这四项能力,对应着我们所提出的感知(Sense)→ 重建(Reconstruct)→ 理解(Understand)→ 创建(Create) 框架——也就是一套真正为物理 AI 生产可用空间数据的流程模型。
| 阶段 | XGRIDS 能力 | 物理 AI 应用 |
| 感知(Sense) | 激光雷达与视觉融合硬件在单次采集中即可获取厘米级几何精度与照片级真实外观。 | 真实捕获部署环境,包括具体空间条件、真实材料和现有障碍物。 |
| 重建(Reconstruct) | 自动化 3DGS 处理流程可生成从建筑到城市尺度的模型,无需手动进行网格清理或表面细节处理。 | 生成符合物理 AI 实际运行尺度的仿真环境,而不局限于单个房间场景。 |
| 理解(Understand) | 在重建过程中同时完成空间测量、标注和语义信息的添加。 | 提供 AI 系统所需的空间上下文:物体位置、尺寸、距离及可通行区域。 |
| 创建(Create) | 输出为 LCC 格式,并支持接入 NVIDIA Omniverse NuRec 的 OpenUSD 渲染流程。 | 为 Physical AI Data Factory 提供高保真的基础环境,供后续合成数据生成进一步扩展。 |
从 NVIDIA 在 GTC 2026 上发布的一系列内容来看,具身智能的整体架构已经越来越清晰。
NVIDIA 的 Omniverse NuRec 负责基于 3DGS 的世界重建,Cosmos 模型用于合成训练数据的生成与扩增,Isaac Sim 负责仿真运行,GR00T 与 Alpamayo 提供机器人与车辆的基础模型,而具身智能数据工厂蓝图 (Physical AI Data Factory Blueprint)则负责将数据整理、训练与评估等环节串联起来。
但这个流程有一个前提:必须先有人把真实世界的环境,转化为整个系统能够使用的“输入”。
NVIDIA 构建的是仿真与训练层。而真正把物理空间转化为结构化三维数据、让整条流程能够跑起来的“采集层”,正是 XGRIDS 所处的位置。
目前,大多数面向机器人的 3DGS 研究,仍然依赖临时性的采集方式:研究人员把相机架在三脚架上,走完整个空间,再自己处理数据。这种方式足以支撑学术研究,却很难支撑具身智能在成千上万个仓库、工地或城市道路场景中的真实部署。
这其实很像早期深度学习基础设施的发展路径。十年前,那些能够规模化完成数据标注、构建数据集流程的公司之所以成为 AI 产业的关键,并不是因为它们训练出了最好的模型,而是因为它们提供了模型所依赖的数据。
根据 Gartner 的预测,到 2030 年,边缘场景中用于 AI 训练的数据将有 90% 来自合成数据,而今天这一比例大约仍在 20% 左右。但问题在于,合成数据并不是凭空生成的,它总是建立在一批“种子环境”之上。而这些种子环境的保真度越高,后续生成出来的合成变化才越有价值。
基于真实采集的 3DGS,就是这个流程中的“种子层”。而如何通过感知(Sense)→ 重建(Reconstruct)→ 理解(Understand)→ 创建(Create)这条流程,把它规模化地生产出来,正是空间智能平台解决的核心命题。
具身智能正在从研究演示走向实际部署。NVIDIA 的 Omniverse NuRec 库已经开始支持用于大规模环境的 3DGS 重建。Discoverse 等开源框架也正在推动现实到仿真到现实(Real2Sim2Real)流程逐步走向标准化。按照 NVIDIA 的说法,机器人已经成为 Hugging Face 上增长最快的类别。
当前的瓶颈正在发生转移。问题不再是 3DGS 是否能够生成足够好的训练环境——研究已经基本回答了这一点。真正的挑战在于,行业是否能够以足够快的速度,在实际部署所需的规模下,持续生产出大量高质量、基于真实采集的三维环境。
这正是空间智能平台的核心价值所在,也是我们正在推进的方向。
.PNG?x-oss-process=image/resize,w_800/quality,Q_50)